

项目简介
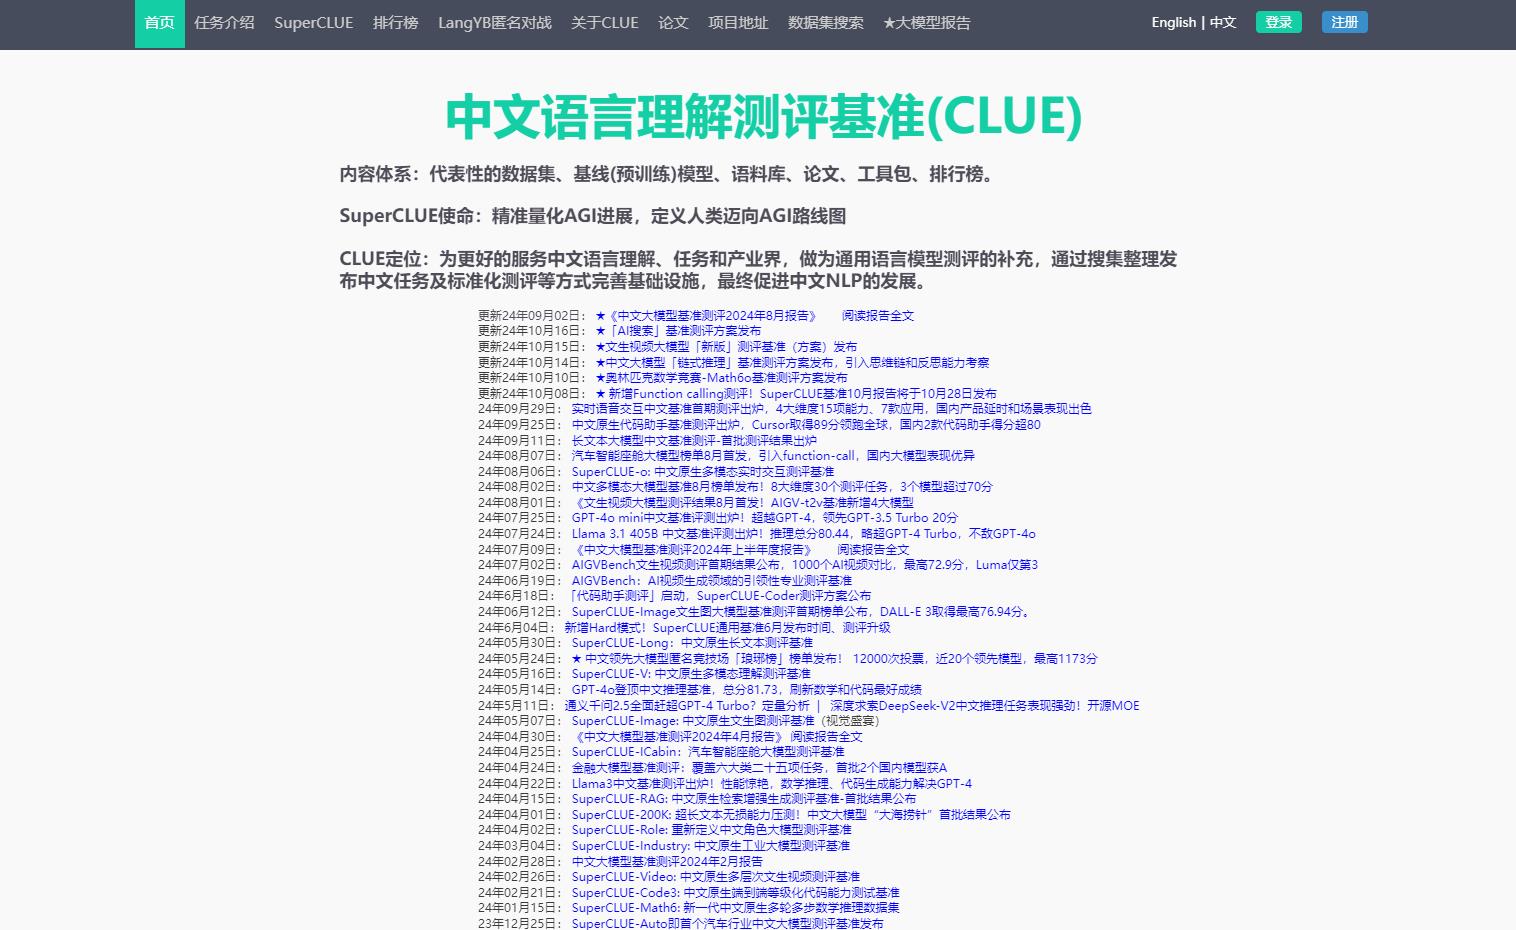
中文语言理解测评基准,包括代表性的数据集、基准(预训练)模型、语料库、排行榜。我们会选择一系列有一定代表性的任务对应的数据集,做为我们测试基准的数据集。这些数据集会覆盖不同的任务、数据量、任务难度。
项目定位
为更好的服务中文语言理解、任务和产业界,做为通用语言模型测评的补充,通过完善中文语言理解基础设施的方式来促进中文语言模型的发展
相关导航



暂无评论...
中文语言理解测评基准,包括代表性的数据集、基准(预训练)模型、语料库、排行榜。我们会选择一系列有一定代表性的任务对应的数据集,做为我们测试基准的数据集。这些数据集会覆盖不同的任务、数据量、任务难度。
为更好的服务中文语言理解、任务和产业界,做为通用语言模型测评的补充,通过完善中文语言理解基础设施的方式来促进中文语言模型的发展